AI 경쟁력은
검증 가능한 흐름에서 완성됩니다

오늘 공식 발표는 모델을 독립적으로 평가하고, 현실 음성을 정확히 이해하며, 적은 활성 연산으로 멀티모달 업무를 처리하고, 여러 클라우드의 데이터를 효율적으로 연결하며, 추론 처리량을 확장하는 운영 조건을 보여줍니다.

5개 핵심 동향 + 2개 종목읽는 시간 약 10분
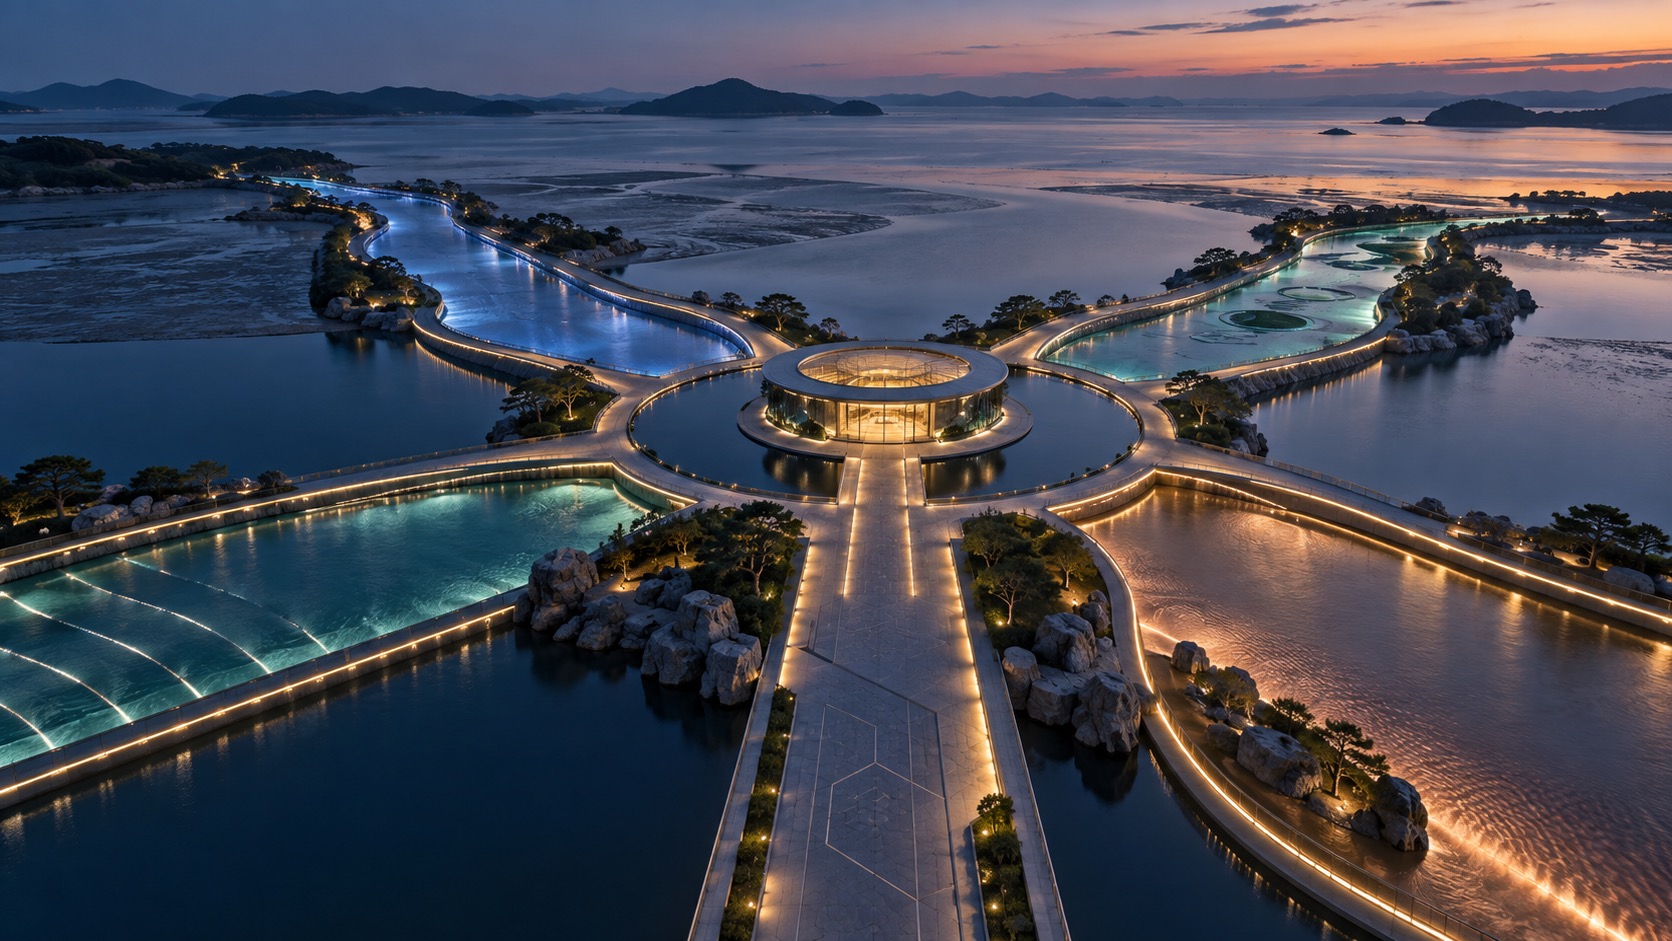
해 질 무렵 다섯 개의 빛나는 수로가 해안의 원형 관측 플랫폼으로 모이는 모습
L2Ksoft가 생성한 다섯 기술 흐름이 하나의 운영 중심으로 모이는 오늘의 비주얼
KRX CLOSED · LAST CLOSE

삼성전자·SK하이닉스 최근 종가

토요일 휴장 중인 2026년 9월 19일 09:33 KST에 매일경제 마켓에서 확인한 9월 18일 마지막 거래일 종가입니다. 다음 개장 시 가격은 달라질 수 있습니다. 가격은 변동될 수 있으며 투자 권유가 아닙니다.

01
ANTHROPIC · INDEPENDENT EVALUATION

프런티어 모델 평가는 개발 과정 안에서 독립성을 확보해야 합니다

Anthropic은 9월 18일 Accenture의 AI 전문 조직 Faculty와 함께 모델 평가·레드팀·정렬 평가·안전장치 시험을 진행하는 내재 평가 파트너십을 발표했습니다. 평가자는 직원과 비슷한 접근 범위에서 모델이 만들어지는 과정과 배포 의사결정을 관찰할 예정입니다.

공식 발표도 접근 범위와 보고 기준, 장기 재원 구조가 아직 확정되지 않았다고 밝힙니다. 평가 조직의 독립성, 공개 범위, 이해상충 관리와 발견 사항의 시정 책임을 계약과 운영 절차로 분명히 해야 합니다.
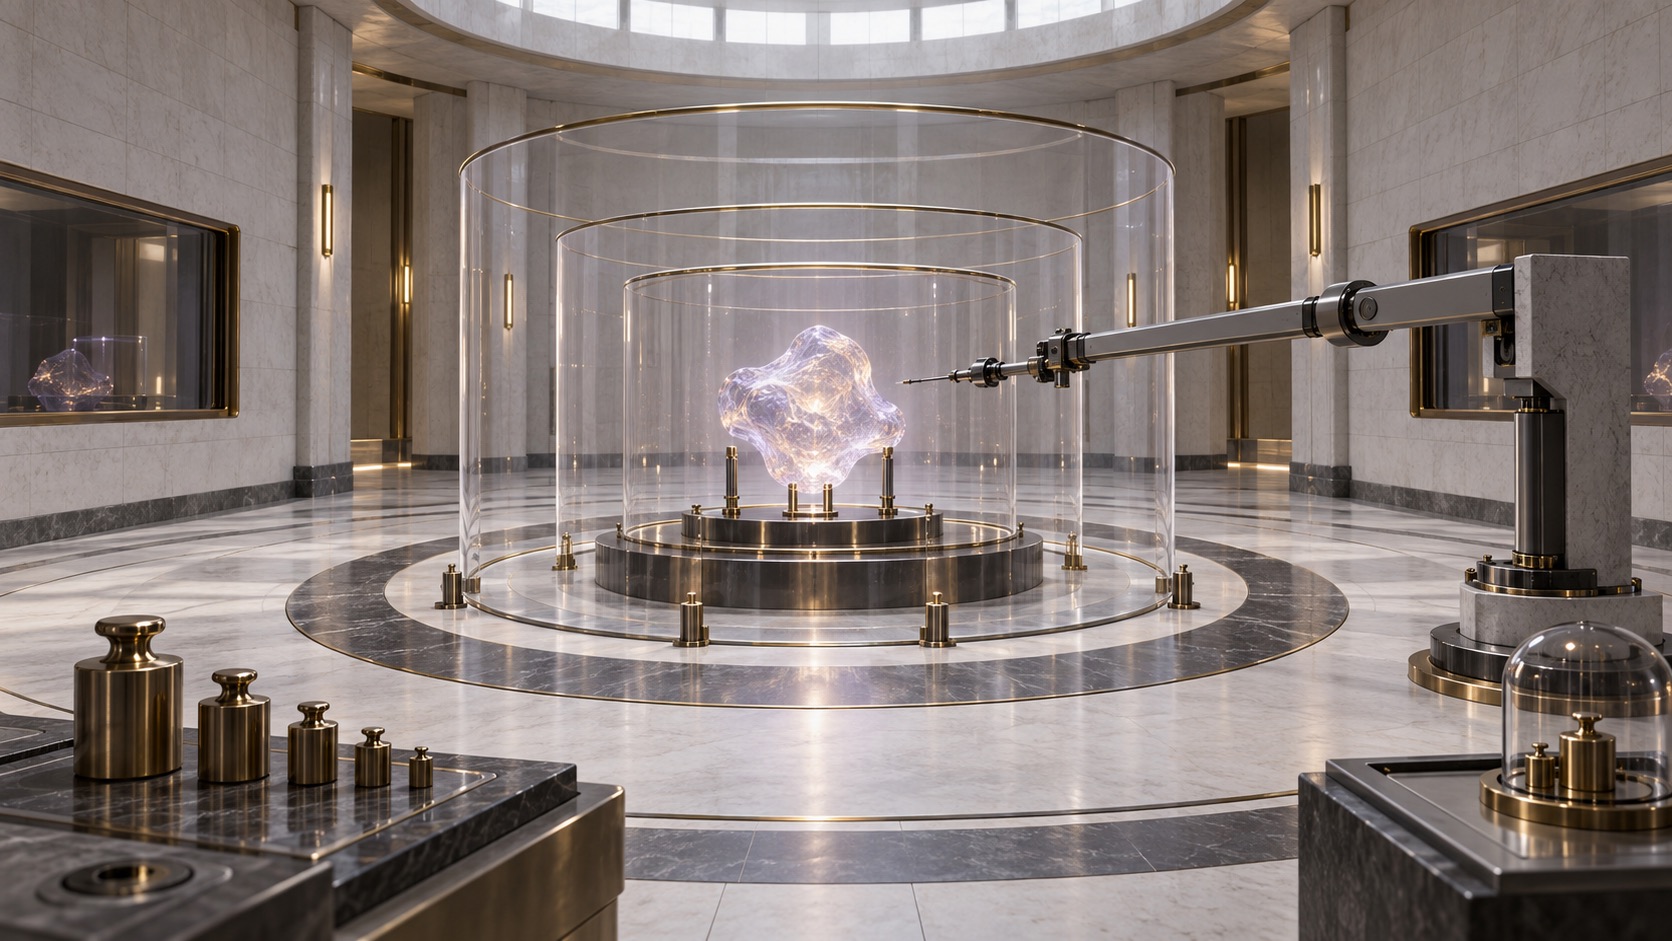
세 겹의 투명 안전 원 안에 놓인 빛나는 물체를 외부 정밀 측정 장치가 검사하는 모습
개발 환경 안에서 독립 평가자가 모델과 안전장치를 지속 검증하는 구조를 표현했습니다.
L2Ksoft 관점기업도 공급사 자체 벤치마크만 받아들이지 말고, 실제 업무 표본과 금지 시나리오를 독립 테스트 세트로 운영해야 합니다. 평가자에게 필요한 로그 접근을 주되 개인정보·영업비밀은 최소화하고, 발견된 결함의 수정 기한과 재검증 기준을 사전에 정해야 합니다.
Anthropic 공식 발표 ·
02
XAI · GROK VOICE

실시간 음성 AI는 깨끗한 데모보다 현장 소음과 언어 전환이 기준입니다

xAI는 9월 18일 배치·스트리밍 전사, 단어별 시각, 화자 분리, 최대 8개 채널, 핵심 용어 편향과 언어 자동 감지를 지원하는 Grok Voice Transcribe 2.0을 공개했습니다. 기존 Speech-to-Text API 연동은 코드 변경 없이 정확도 개선을 받는다고 설명합니다.

공개 수치와 내부 평가는 출발점일 뿐입니다. 전화 회선, 지역 억양, 도메인 용어, 개인정보 마스킹, 화자 겹침과 지연 요구가 다른 실제 업무 녹음으로 별도 검증해야 합니다.

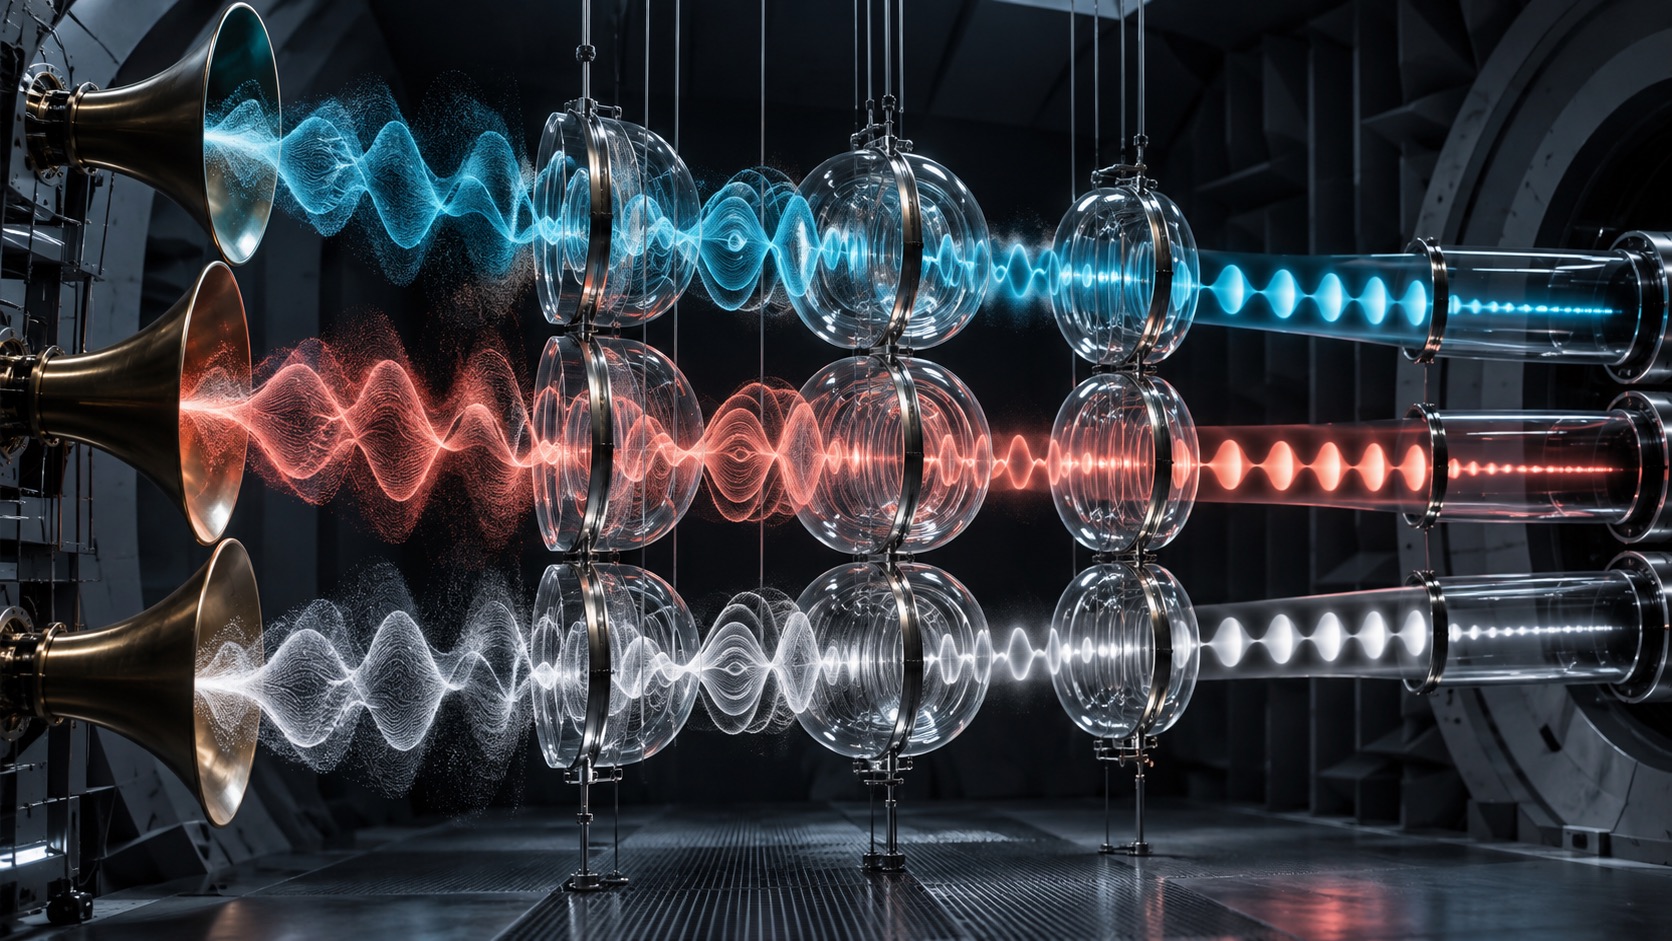
세 가지 색의 음파가 유리 공명 장치를 지나 고른 신호 흐름으로 정리되는 모습
소음과 서로 다른 음색의 음성을 실시간으로 분리하고 정돈하는 과정을 시각화했습니다.
L2Ksoft 관점콜센터·회의·현장 음성 PoC는 평균 오류율뿐 아니라 고유명사, 숫자, 코드, 화자 분리, 첫 결과 지연과 수정 지연을 함께 측정해야 합니다. 원음 보존기간과 전사 접근권한, 삭제 절차도 정확도 시험과 같은 우선순위로 검증해야 합니다.
xAI 공식 발표 ·
03
Z.AI · GLM MULTIMODAL

적은 활성 연산이 멀티모달 업무의 비용 구조를 바꿀 수 있습니다

Z.ai는 9월 19일 GLM-5 계열 첫 네이티브 멀티모달 모델인 GLM-5.3-Flash를 공개했습니다. 전체 320B 중 18B 활성 파라미터, 희소·선형 어텐션 혼합, 최대 100만 토큰 문맥을 위한 캐시 압축과 공개 가중치·MIT 라이선스를 주요 특징으로 제시했습니다.

발표된 성능·효율 수치는 Z.ai의 평가와 서빙 환경을 기준으로 합니다. 실제 배포에서는 문서·이미지·영상 조합별 정확도, 메모리, 첫 토큰 지연, 처리량, 양자화 품질과 운영 프레임워크 호환성을 확인해야 합니다.

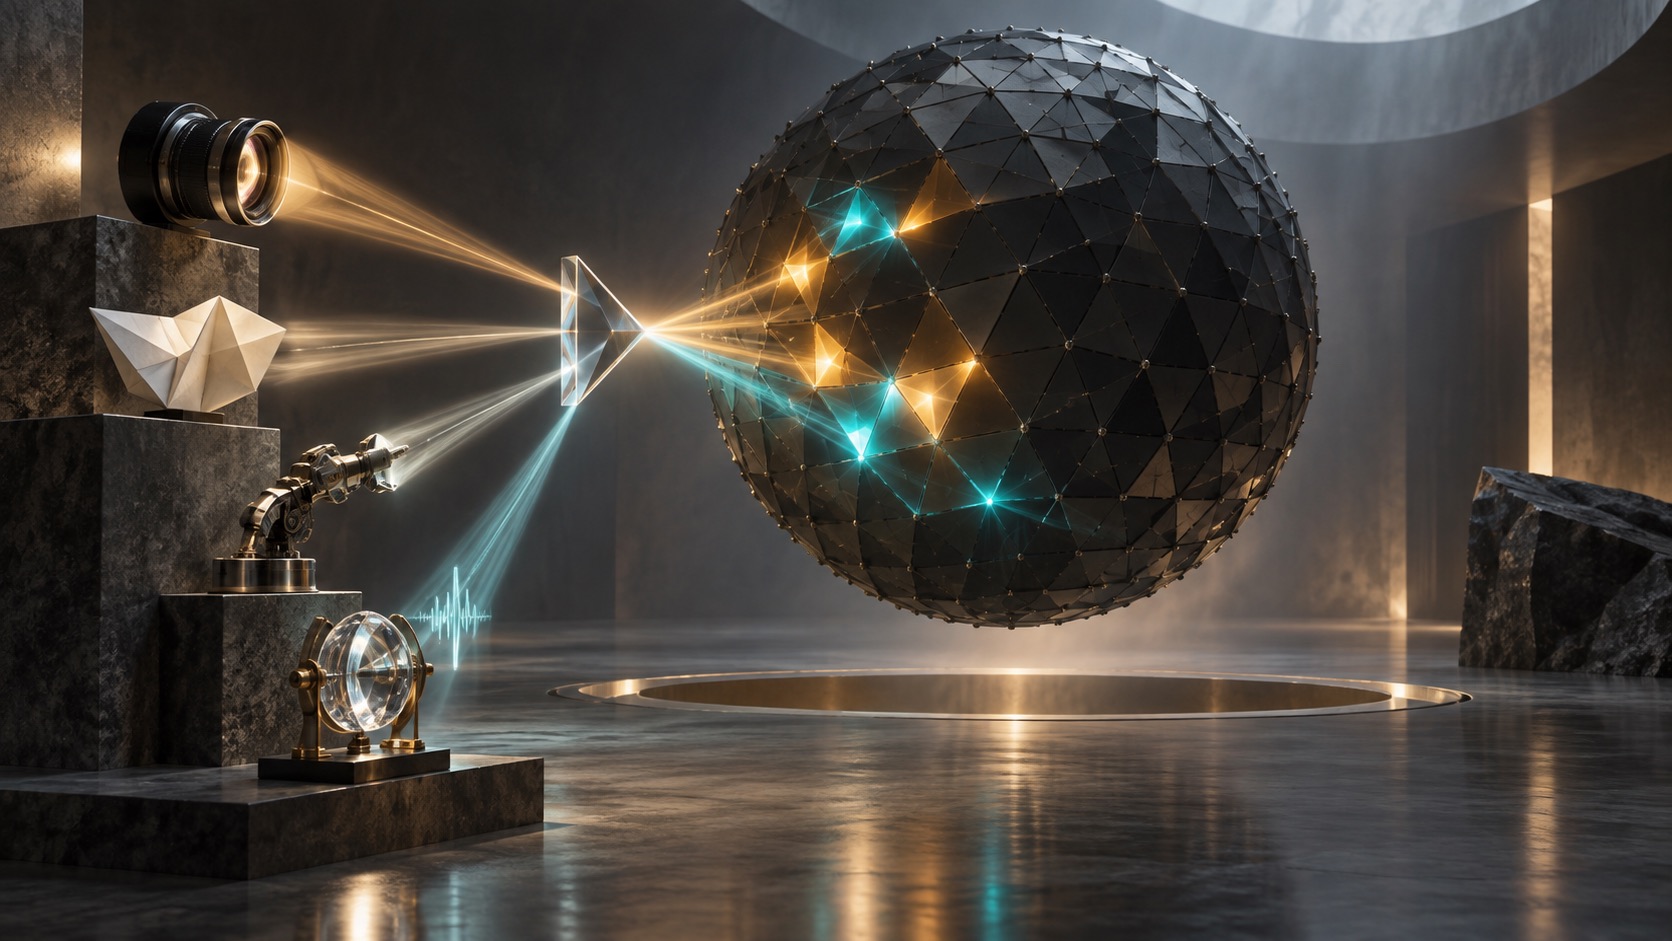
렌즈와 종이·도구·음향 신호가 프리즘을 거쳐 거대한 구체의 일부 면만 밝히는 모습
여러 형태의 입력을 결합하면서 필요한 일부 연산 경로만 활성화하는 효율성을 표현했습니다.
L2Ksoft 관점오픈 가중치 모델은 라이선스만으로 운영 적합성이 보장되지 않습니다. 목표 하드웨어에서 실제 문서 렌더링과 도구 사용을 포함한 종단 시험을 수행하고, 품질 하한·비용 상한·지원 가능한 문맥 길이를 업무별로 고정해야 합니다.
Z.ai AutoClaw 공식 발표 ·
04
GOOGLE CLOUD · DATA PLATFORM

멀티클라우드 AI는 데이터를 옮기는 양부터 줄여야 합니다

Google Cloud는 9월 18일 BigQuery가 다른 클라우드의 Iceberg·Parquet 데이터를 질의할 때 필요한 블록만 지역 캐시에 보관하는 교차 클라우드 캐싱 프리뷰를 발표했습니다. 변경 여부와 접근권한을 확인하고, 프로젝트·카탈로그·리전 경계를 유지한다고 설명합니다.

공식 사례의 전송 절감률은 특정 압축률·캐시 적중률·질의 패턴에 따른 결과입니다. 데이터 신선도, 퇴출 정책, 리전 규제와 이그레스 비용을 실제 워크로드에서 측정해야 합니다.

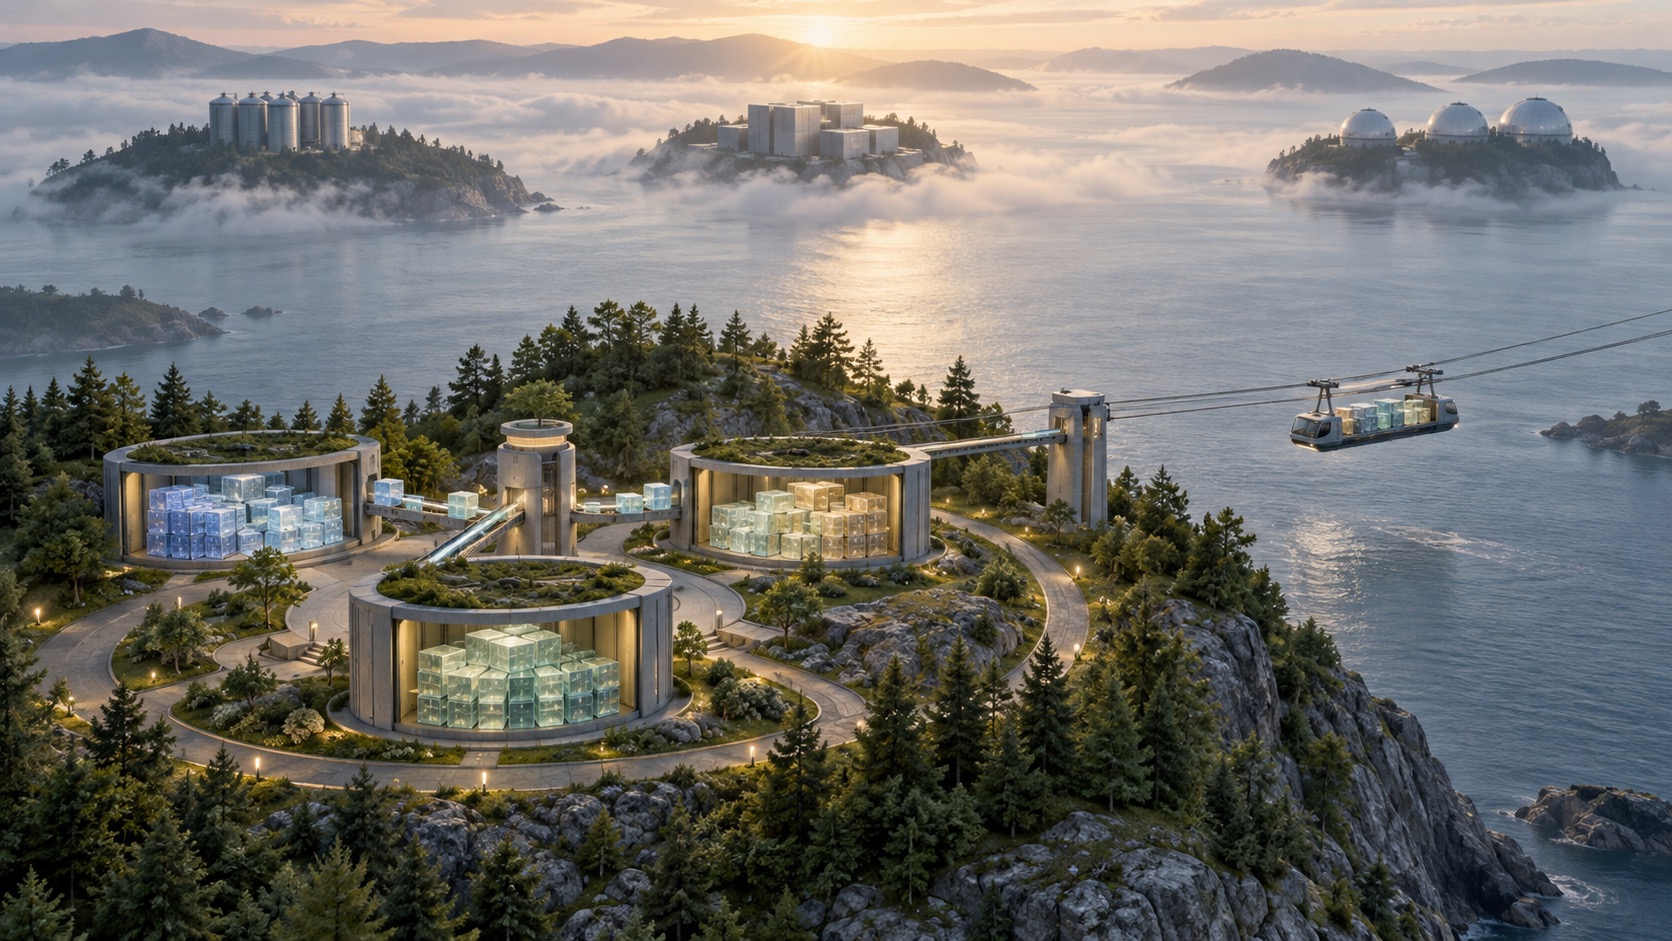
서로 다른 저장 시설이 있는 섬들 사이에서 가까운 저장소가 투명 블록을 재사용하는 모습
원격 데이터를 반복 운반하지 않고 필요한 블록만 가까운 캐시에서 재사용하는 구조를 표현했습니다.
L2Ksoft 관점교차 클라우드 분석은 쿼리당 원격 읽기 바이트, 캐시 적중률, 데이터 갱신 지연과 이그레스 비용을 함께 관찰해야 합니다. 민감 데이터는 캐시 리전·암호화·삭제·권한 철회가 원본 정책과 일치하는지 검증한 뒤 적용해야 합니다.
Google Cloud 공식 블로그 ·
05
NVIDIA · AI INFERENCE

추론 경제성은 칩보다 랙·네트워크·소프트웨어의 합으로 결정됩니다

NVIDIA는 9월 16일 MLPerf Inference v6.1 프리뷰에서 Vera Rubin NVL72가 Qwen3-VL과 DeepSeek-R1 추론 처리량을 높였고, GB300 NVL72 4개 랙 구성은 99% 스케일링 효율을 보였다고 발표했습니다. 저정밀도·커널 융합·프리필과 디코드 분리 등 소프트웨어 최적화도 함께 강조했습니다.

프리뷰 결과와 공급사 발표 수치는 실제 서비스 비용을 대신하지 않습니다. 모델, 요청 길이, 동시성, 지연 목표, 전력·냉각과 장애 상황을 반영한 자체 부하 시험으로 비교해야 합니다.

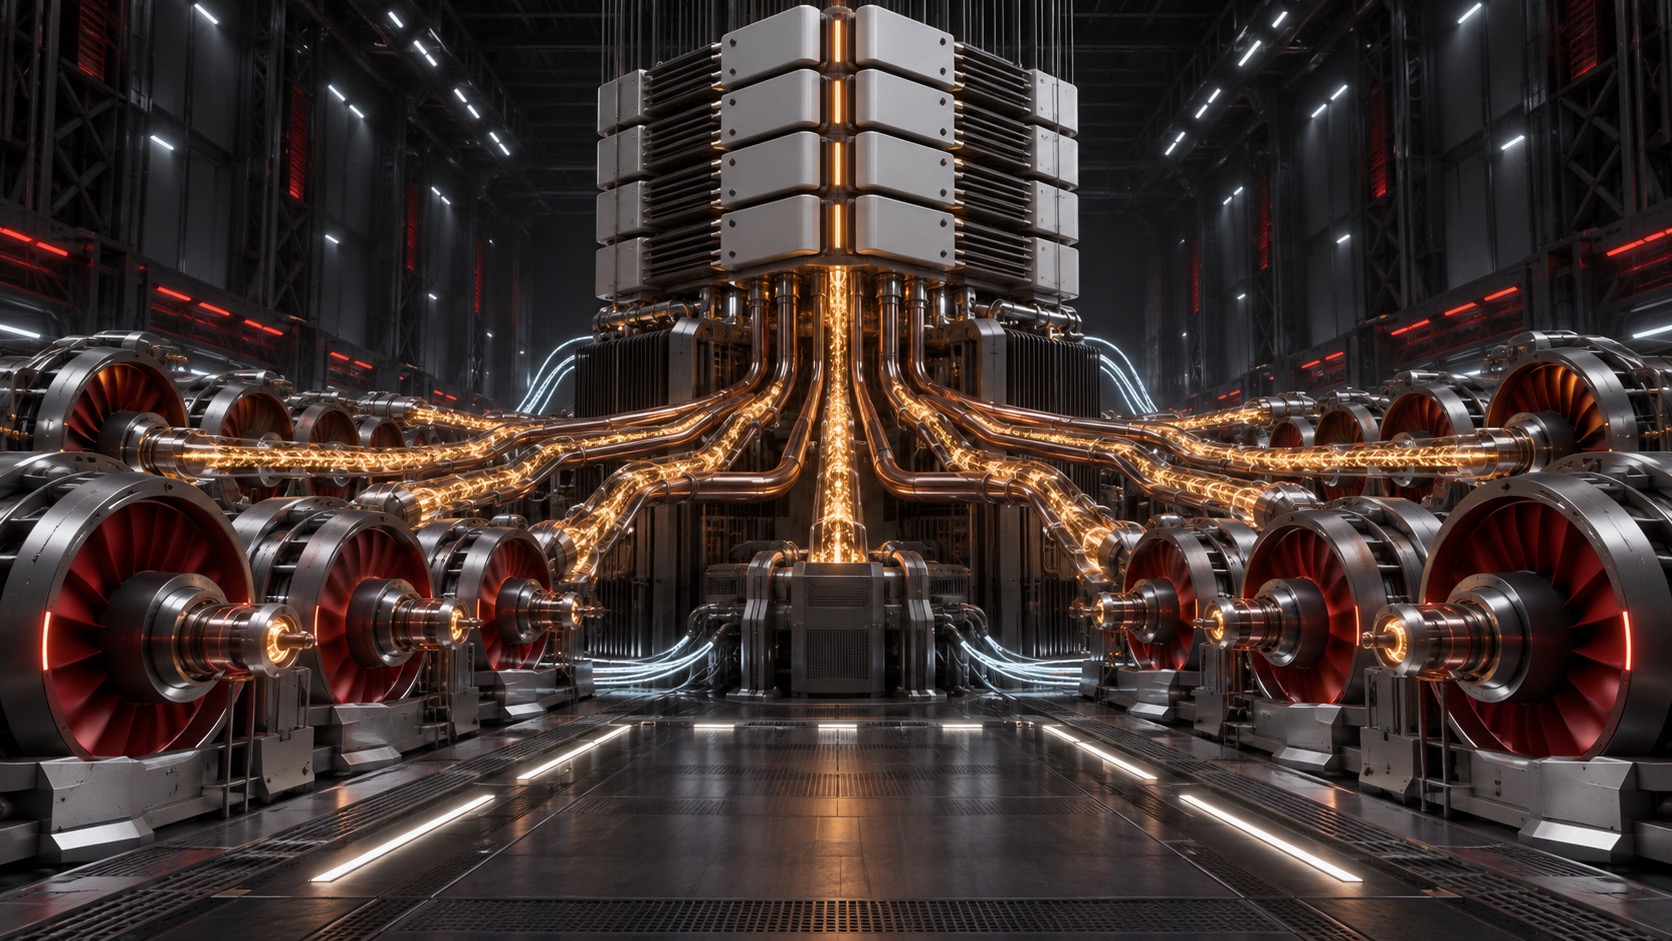
세라믹 연산 타일에서 나온 빛의 흐름이 여러 개의 동기화된 터빈으로 퍼지는 모습
하드웨어와 연결망·소프트웨어가 함께 맞물릴 때 처리량이 비례해 늘어나는 구조를 표현했습니다.
L2Ksoft 관점인프라 도입 비교표에는 GPU 수보다 요청당 비용, P95·P99 지연, 처리량, 전력, 모델 전환 시간과 장애 시 성능을 넣어야 합니다. 벤치마크 설정을 고정하고 소프트웨어 버전별 결과를 남겨야 업그레이드 효과와 회귀를 구분할 수 있습니다.
NVIDIA 공식 블로그 ·