AI의 접점이 넓을수록
운영 기준은 더 정교해집니다

오늘 공식 발표는 데스크톱의 AI 진입점, 여러 AI 호스트에 걸친 대화형 서비스, 반복 프롬프트의 추론 효율, 공급망 전문가 판단의 지식화를 실제 운영 체계로 연결하는 방법을 보여줍니다.

4개 핵심 동향 + 2개 종목읽는 시간 약 8분
서로 다른 다섯 형태의 대형 연이 붉은 대지 위 검은 원형 거점에 연결된 AI·반도체 시장 비주얼
L2Ksoft가 생성한 데스크톱 AI·대화형 앱·추론 인프라·공급망 의사결정을 아우르는 오늘의 비주얼
KRX OPEN · INTRADAY

삼성전자·SK하이닉스 장중 시세

한국거래소(KRX) 장중 시세를 Npay 증권에서 2026년 9월 14일 09:35 KST에 조회했습니다. 장중 가격과 고가·저가는 계속 바뀔 수 있습니다. 가격은 변동될 수 있으며 투자 권유가 아닙니다.

01
GOOGLE · GEMINI FOR WINDOWS

데스크톱 AI는 빠른 진입점과 업무 데이터 경계를 함께 설계해야 합니다

Google은 9월 10일 Windows 10·11용 Gemini 앱을 전 세계에 출시했습니다. 사용자는 Alt+Space로 현재 작업 위에 Gemini를 열고, 전용 작업 공간에서 다단계 과제를 맡기거나 Gmail·Google Drive의 정보를 활용한 요약, 이미지·동영상 생성을 수행할 수 있습니다. 일부 기능은 구독과 이용 가능 조건이 적용됩니다.

브라우저 밖의 상시 진입점은 전환 비용을 줄이지만, 화면과 연결 계정에 가까워지는 만큼 조직 정책도 세밀해져야 합니다. 업무용 기기 배포 범위, 연결 가능한 Google 앱, 생성 파일의 저장 위치와 감사 기록을 도입 전에 정해야 합니다.
커다란 기하학 스테인드글라스 창의 빛이 나무 작업대 위 도구를 여러 색으로 정돈하는 이미지
데스크톱 작업 흐름을 끊지 않고 AI 도움을 불러오되, 들어오는 빛의 경계를 통제하는 모습을 표현했습니다.
L2Ksoft 관점기업 배포는 단축키 편의성보다 먼저 계정 분리, 연결 앱 허용 목록, 민감 문서 처리 규칙과 결과물 보존 정책을 정해야 합니다. 소규모 부서에서 실제 전환 시간과 수정률을 측정한 뒤 배포 범위를 넓히면 편의성과 통제 수준을 함께 검증할 수 있습니다.
Google 공식 블로그 ·
02
AWS · AGENTCORE MCP APPS

대화형 AI 서비스는 화면과 업무 로직을 얇은 표준 계층으로 분리할 수 있습니다

AWS는 9월 11일 Amazon Bedrock AgentCore에서 대화 안에 HTML 위젯을 렌더링하는 MCP Apps 구축 예제를 공개했습니다. 하나의 MCP 서버가 도구와 화면 리소스를 제공하고, 핵심 업무 로직은 Lambda와 DynamoDB에 분리해 ChatGPT·Claude 등 MCP Apps 확장을 지원하는 호스트에서 같은 경험을 제공하는 구조입니다.

예제는 AgentCore Gateway, IAM 실행 역할, WAF, 세션 격리와 자동 확장을 조합합니다. 다만 샘플의 외부 진입은 인증 없음과 IP 허용 목록을 사용하므로, 실제 고객·사내 서비스에는 사용자 인증, 세밀한 권한, 인수값 재검증, 호출 감사와 비용 한도를 별도로 설계해야 합니다.

흰 세라믹 모듈 네 개가 황동 관으로 중앙 실행 장치와 연결되고 각 모듈이 다른 물체를 다루는 이미지
호스트별 화면은 여러 모듈로 제공하면서 중앙 프로토콜 계층과 기존 업무 로직을 분리하는 구조를 표현했습니다.
L2Ksoft 관점MCP 계층은 도구 스키마와 화면 리소스만 담당하고 결제·예약·승인 같은 핵심 규칙은 기존 API에 남겨야 변경 위험이 줄어듭니다. 호스트별 렌더링 회귀 테스트, 도구 인수값 검증, 테넌트 경계, 재시도 멱등성과 호출별 추적 ID를 배포 기준에 포함해야 합니다.
AWS 공식 기술 블로그 ·
03
AWS · SAGEMAKER INFERENCE

반복 프롬프트는 캐시 기능보다 요청 배치 방식이 성능을 좌우합니다

AWS는 9월 10일 같은 시작 부분을 가진 요청을 동일 인스턴스로 보내 KV 캐시 재사용을 높이는 SageMaker Inference의 접두사 인식 라우팅을 발표했습니다. Llama 3.1 70B와 7대의 ml.p5.48xlarge를 사용한 공급사 시험에서 긴 공통 접두사 워크로드의 P50 첫 토큰 시간이 71~77% 줄고 처리량은 15~16% 늘었습니다.

공식 결과는 vLLM의 접두사 캐시를 켜고 특정 모델·인스턴스·부하로 측정한 값입니다. 짧은 대화형 워크로드의 처리량 향상은 1.7~2.0%였으며, 과부하 시 다른 인스턴스로 우회해 캐시 적중보다 가용성을 우선하는 보호 장치도 포함됩니다.

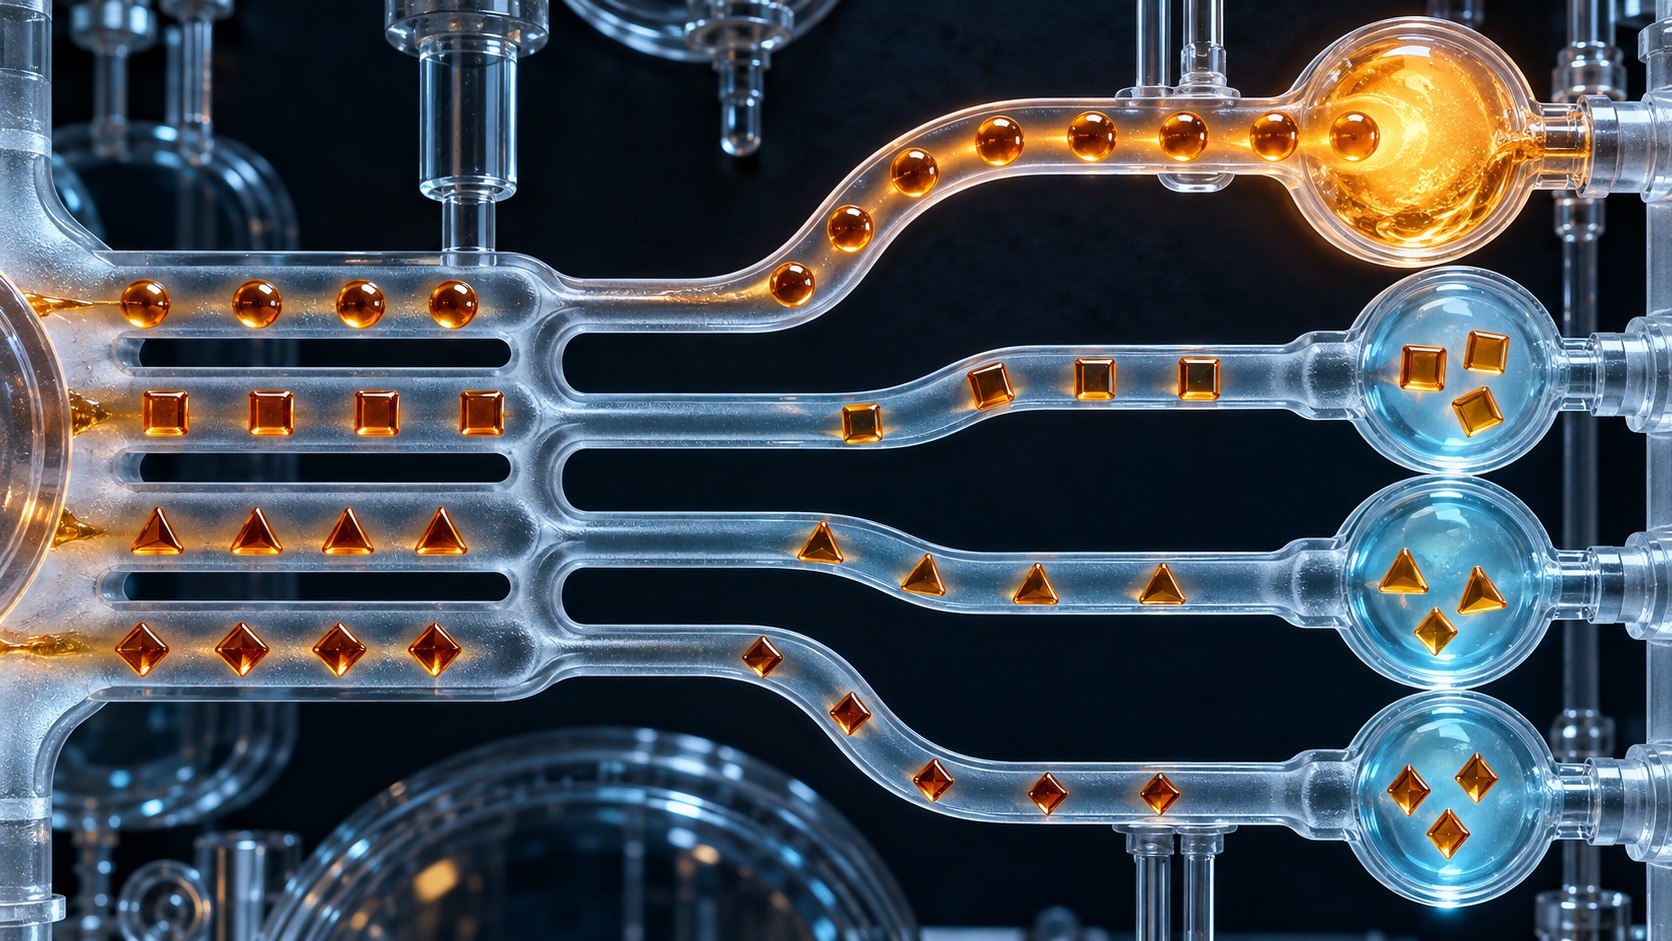
같은 모양의 호박색 결정들이 투명 유리 모세관의 동일 경로를 따라 각기 다른 빛 저장소로 모이는 이미지
요청의 반복되는 시작 형태를 기준으로 일관된 경로에 모아 계산 결과를 재사용하는 방식을 표현했습니다.
L2Ksoft 관점도입 전 실제 시스템 프롬프트 길이, 공통 접두사 비율, 동시 요청 편향을 기록하고 무작위·최소 대기·접두사 인식 라우팅을 같은 부하로 비교해야 합니다. P50뿐 아니라 P95 지연, 캐시 적중률, 인스턴스 편중, 스케일 변경 뒤 회복 시간과 요청당 비용을 함께 봐야 합니다.
AWS 공식 기술 블로그 ·
04
NVIDIA · SUPPLY CHAIN AI

전문가 판단을 AI로 옮기려면 결정 당시의 근거와 결과를 함께 남겨야 합니다

NVIDIA는 9월 10일 Palantir Foundry의 운영 데이터와 NVIDIA cuOpt, 맞춤 학습한 Nemotron 3.5 Lightning을 연결한 자사 공급망 의사결정 사례를 공개했습니다. 부품·생산지·용량·할당·비정형 신호를 하나의 관리 계층에 모으고, 수학적 최적화가 놓치는 현장 이메일·기상·지정학·공급사 대화 같은 전문가 근거를 모델 학습 기록으로 남깁니다.

개발 벤치마크에서 맞춤 모델의 할당 의사결정 정확도가 86.7%였다는 공급사 결과가 제시됐지만, 특정 내부 과제와 평가 데이터의 결과입니다. 배포 전 시점으로 되돌린 백테스트를 통과해야 하며 모델이 스스로 재학습하지 않고, 최종 판단은 계획 담당자가 검토하는 구조입니다.

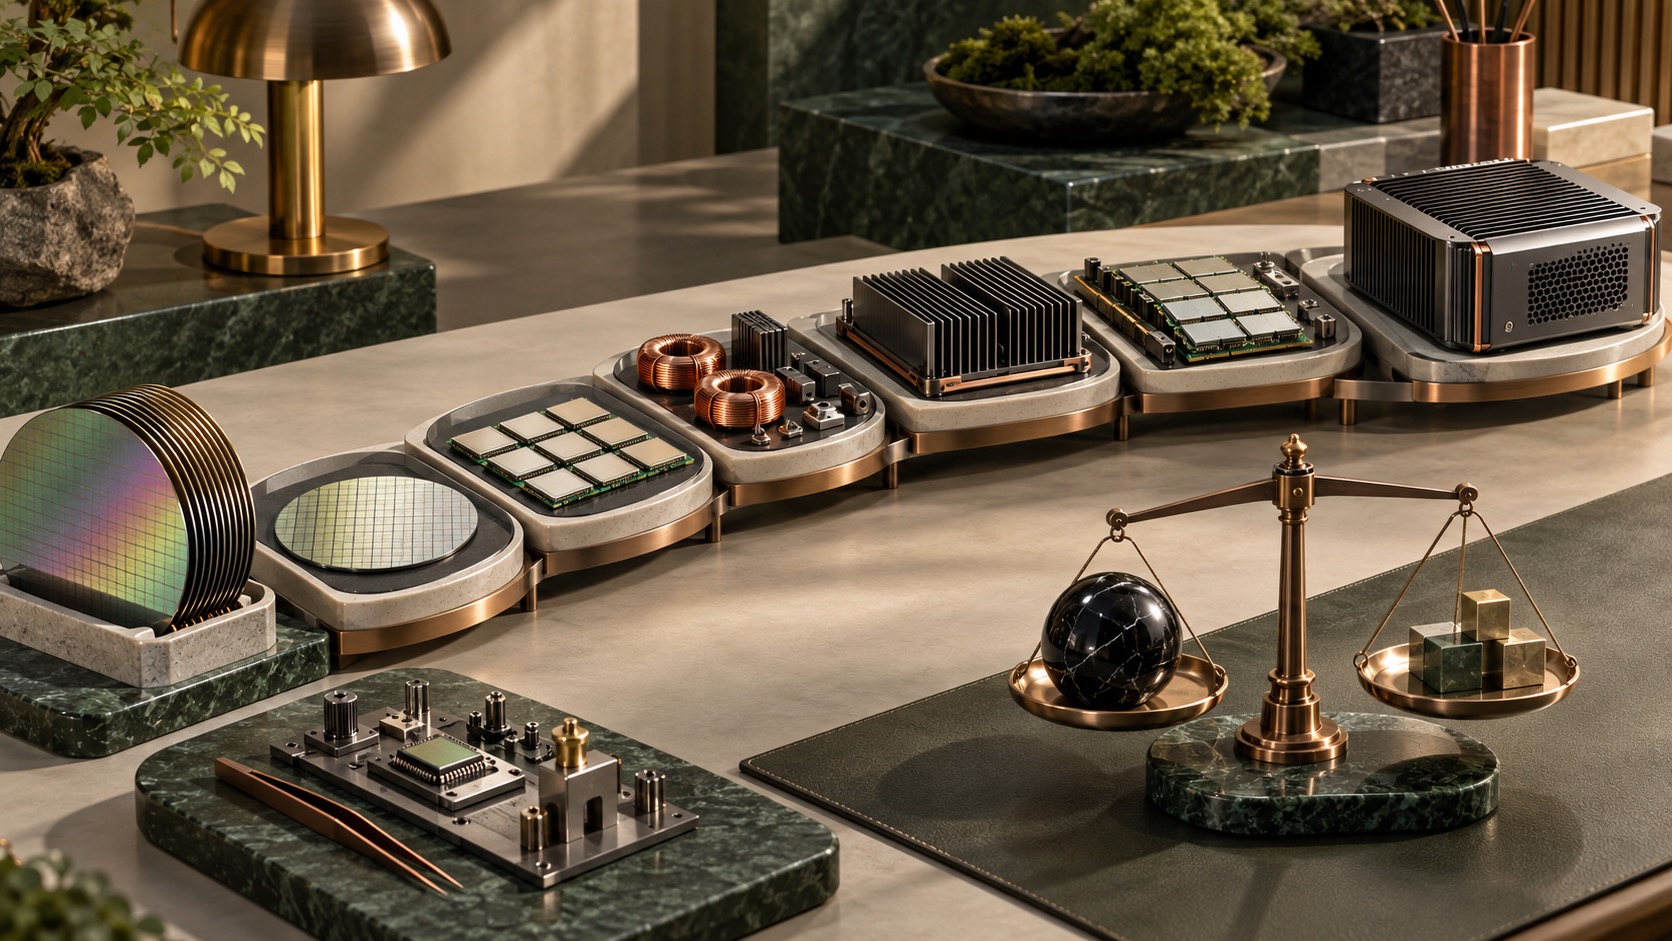
반도체 웨이퍼와 냉각 핀, 구리 코일이 정밀 트레이를 따라 완성 장치로 조립되고 앞쪽 저울이 결정을 비교하는 이미지
여러 핵심 부품의 제약을 조정해 완성 시스템으로 연결하고, 모델 권고를 별도 판단 장치에서 검토하는 과정을 표현했습니다.
L2Ksoft 관점현업 판단 자동화는 입력 데이터뿐 아니라 당시 알 수 있었던 근거, 담당자의 수정·거부, 실제 결과를 같은 결정 ID로 연결해야 합니다. 개인정보·민감 필드 익명화, 시점 고정 백테스트, 모델·데이터 계보, 승인 임계값과 수동 복귀 절차를 갖춰야 조직 지식이 안전하게 누적됩니다.
NVIDIA 공식 기술 블로그 ·